购买小电拼 Mirror

购买入口即将开放。

微信扫码购买小电拼 Mirror

看得见的每一瓦

充电这件事,本该看得见。

Telemetry 把充电状态从黑盒变成数据。一眼就能看懂此刻在发生什么;想深挖,端口、协议、功率、温度、系统事件全都摊开,接进你自己的看板和自动化。

现象有据可查

设备只拉到 45W?数据会告诉你为什么。

设备只拉到 45W、电脑插上后手机悄悄降功率、换根线功率就变——这些现象,光看屏幕上一个数字解释不清,得把端口、协议、功率、温度和系统事件放在一起看。Mirror 把这些状态全纳入 Telemetry。

Telemetry 覆盖启动信息、固件版本、内存、温度、网络、MQTT、历史功率、实时分配、端口统计、PD pcap、OTA 进度、配置同步、任务结果和告警。同一份数据,既能讲清楚此刻在发生什么,也够你顺着它一路排到根因。

这份透明度让自由流的每一次调度都有迹可循,也让第三方集成更顺手。你可以搭自己的看板、写自动化规则、留充电日志;真出了异常,也能判断问题出在设备、线材、协议、温度还是策略。
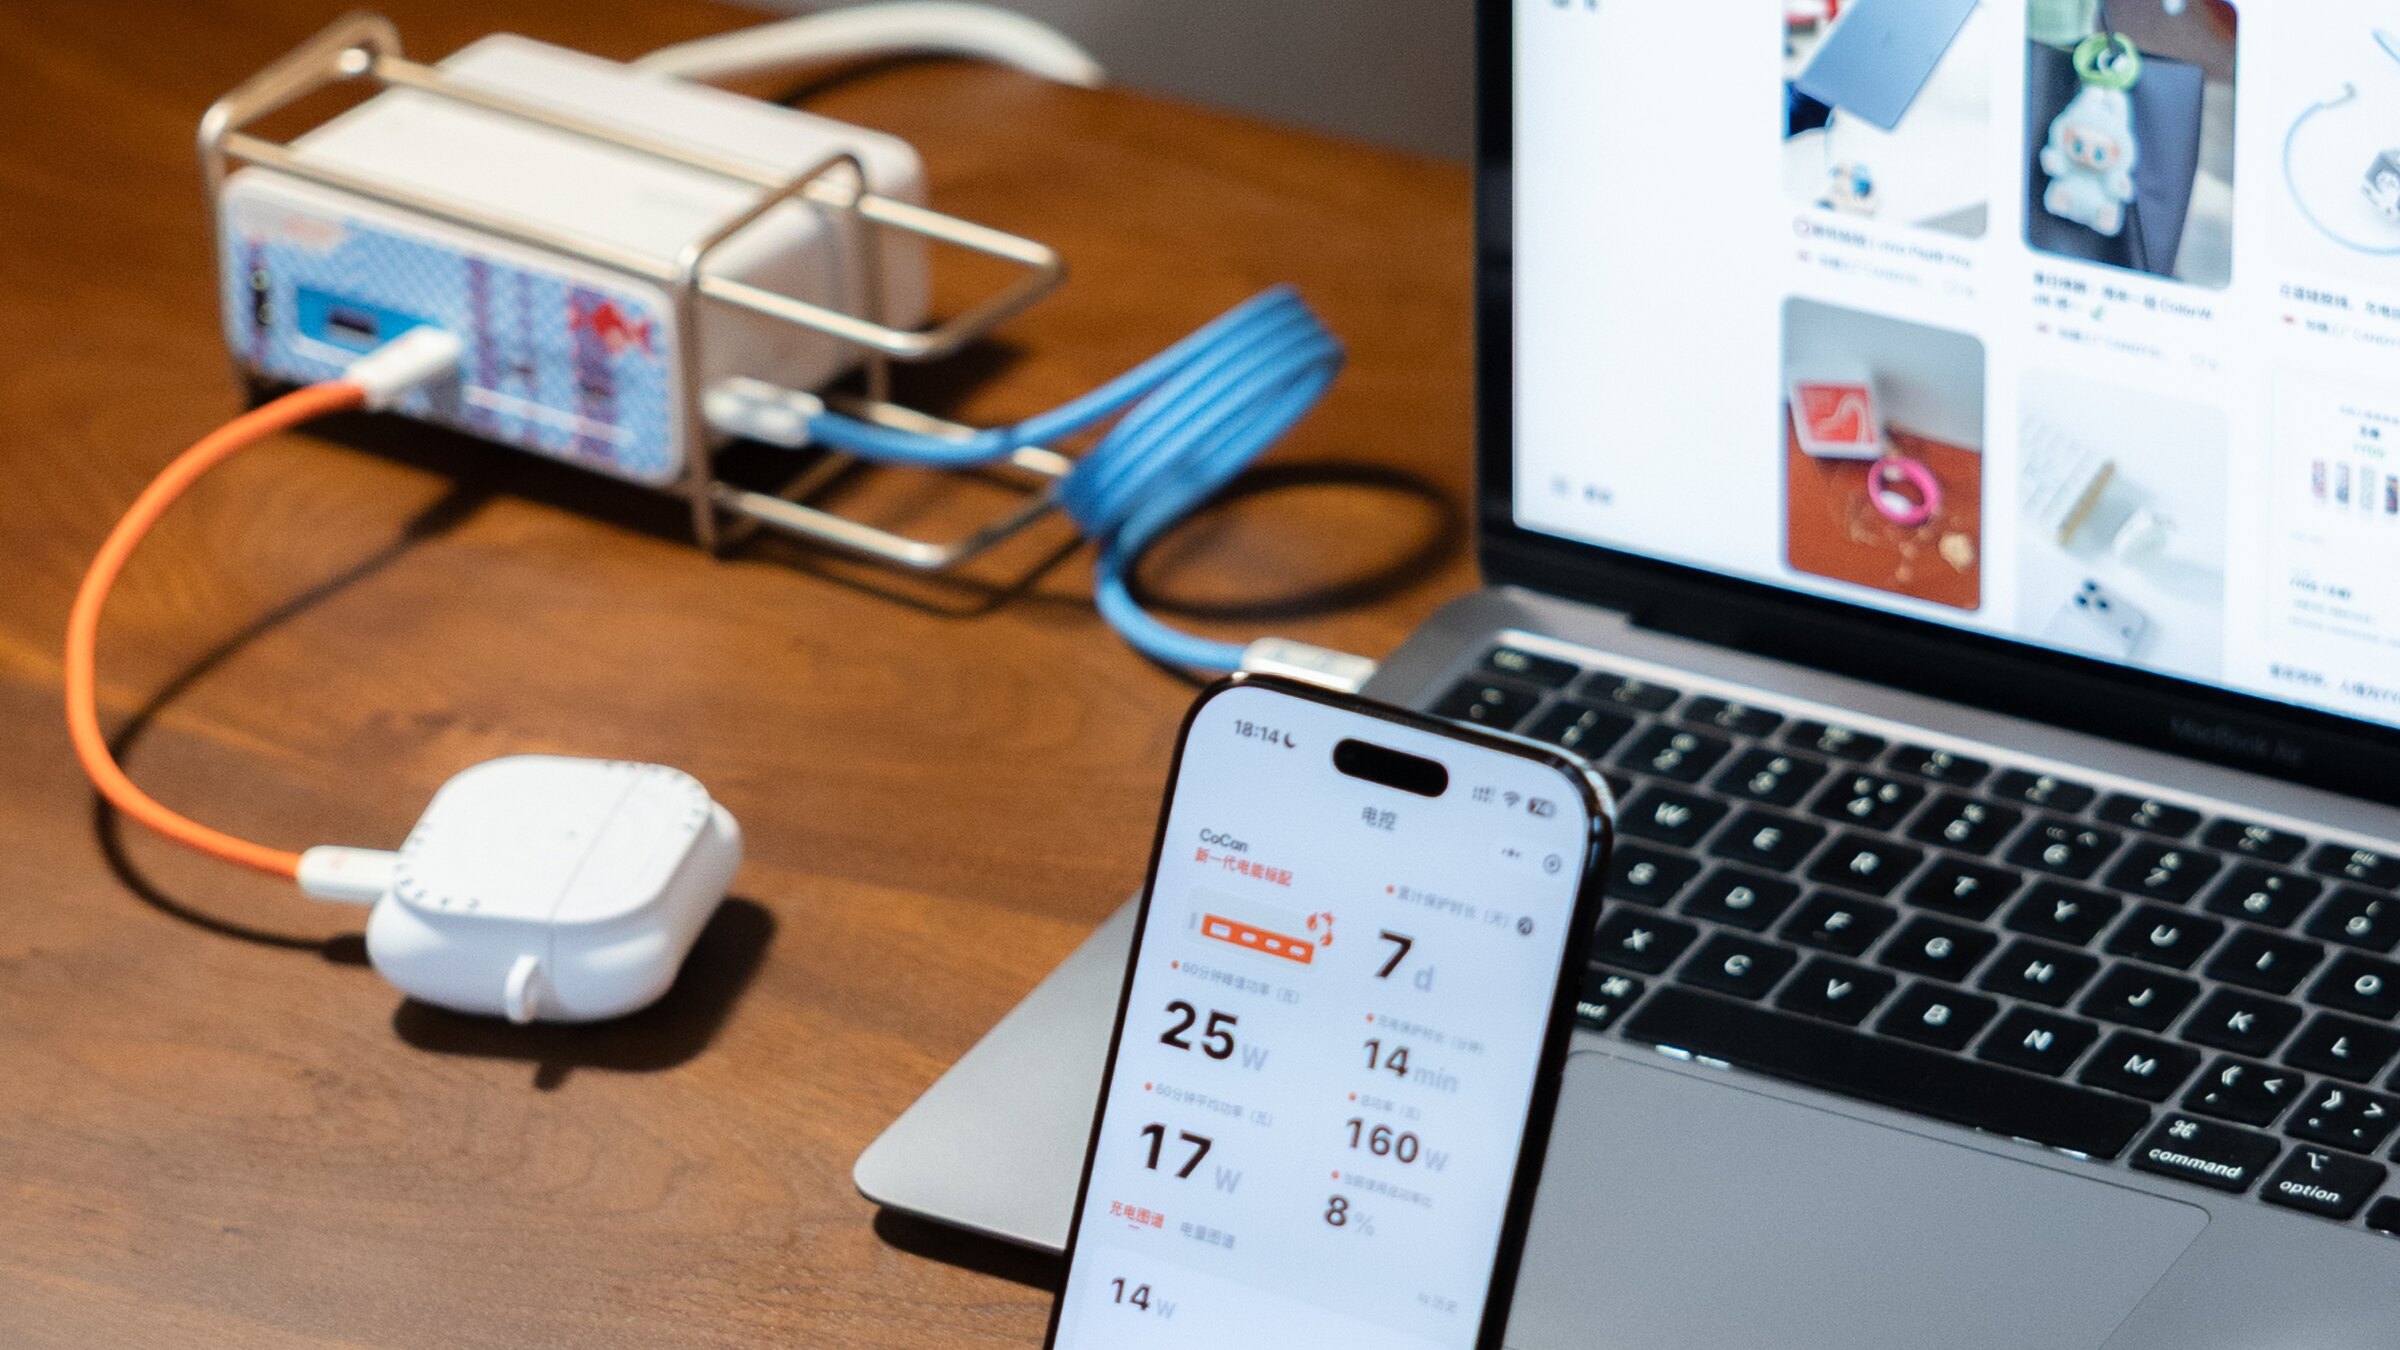
用户通过 App 查看并控制 AI 小电拼 Mirror 充电状态
可见状态 状态在 App 里,也在设备正面。

ingBar 把关键状态放在桌面上,Telemetry 则把更深的数据交给看板、脚本和自动化。

Telemetry数据流

从启动到功率曲线

01

设备状态

启动信息、固件版本、内存、温度、网络、MQTT 和运行时间。

02

功率数据

历史功率、实时分配、端口统计和 PD pcap 数据流。

03

系统事件

OTA 进度、任务结果、配置同步、告警和程序器状态。

留给好奇心

给好奇心留出接口。

你可以看见设备是否在线、哪一个端口最忙、什么时候温度升高、哪台设备正在改变功率请求。设备本地的 Prometheus 和 JSON 指标可以直接喂给 Grafana,充电从猜测变成可以长期记录的数据。

排障面

把异常现象变成证据链。

01

PD pcap

PD 数据流能帮助分析协商、请求和设备能力。

02

Cable Intelligence

线材 VID/PID、EPR 能力、电流、电压和 eMarker 信息可以进入诊断。

03

Allocator State

实时分配和历史功率让用户看懂 FluxAI® 如何使用 160W 预算。

04

System Events

OTA、配置同步、任务执行、内存和温度告警都能形成可追踪事件。

把状态变成事件

充不上、功率不对,先变成查得到的数据。

充电异常很难凭肉眼判断。设备没到预期功率,可能是线材,可能是协议、电池温度、系统负载、端口优先级,也可能是整机预算。Mirror 把这些可能性拆成数据:设备状态、端口状态、功率历史、实时分配、PD pcap、温度、告警,一项一项摆出来。

启动信息和设备统计帮你看清固件版本、运行时间、内存和网络状态;功率历史还原设备从高功率阶段进入低功率阶段的过程;实时分配说明 160W 预算此刻流向哪里;端口统计显示哪个口最忙。一句含糊的"好像有点慢",变成一串具体的数字。

PD pcap 把证据留到协议这一层。协商、请求、设备能力的数据都能调出来,Source_Capabilities、Request、Accept 还原得清清楚楚。"充不上""功率不对""换根线就变快"这些说不清的现象,变成摆得上台面的证据。

同一套Telemetry,也能把现状讲清楚。FluxAI® 和界面用它解释当前状态,让你知道是设备接近满电、线材限制、温度策略生效,还是别的设备占了预算。它支持本地 Prometheus 和 JSON 输出,数据先落在本地,要查随时查。

进个人工作流

可观测的充电,能接进你自己的看板。

读屏幕、接看板、触发自动化——Telemetry 让这三种用法都立在同一套事实之上,互不打架。

举几个具体的:记录每天电脑和手机的充电曲线,看某根线是否稳定支持高功率;温度升高时切到温控模式;夜里把显示亮度压低;工作日早晨让电脑端口优先。这些都建立在设备上报的数据上,不靠猜。

定时任务和 Telemetry 结果还能形成闭环:设备按时间执行命令,再通过任务结果回报执行状态。配置同步让多端控制少打架——端口配置和充电策略可以上传、应用、重试、去抖,几个入口同时改设置,也不会互相覆盖。

透明产品的价值很具体:你不用天天研究协议,出了异常有数据可查,想扩展有接口可接,FluxAI® 的决策也有真实状态撑着。看得见,才管得住。

异常可分析

同一台电脑今天只有 60W?查得清原因。

用户遇到的充电现象往往很具体:同一台电脑今天只有 60W,换根线就变快;手机在电脑接入后降功率;夜里温度更高。没有 Telemetry,这些只能靠经验猜;有了 Telemetry,每一条都能追到原因。

Mirror 把关键状态分开记录。端口状态说明连接和协议,历史功率说明变化过程,实时分配说明预算流向,温度告警说明保护策略,配置报告说明当前模式和端口设置。哪一环出了岔子,对照着看就清楚。

PD pcap 给协议层留下证据。它还原 Source_Capabilities、Request、Accept 等协商过程,也看得出设备到底有没有请求某个档位。真要排查问题,这些数据远比屏幕上一个功率数字管用。

这些 Telemetry,FluxAI®、App、脚本和看板都能共用。解释、记录、自动化用的是同一套事实,体验因此一致——你在屏幕上看到的、脚本里读到的、智能体据以决策的,从来是同一份真相。

一条曲线胜过一个数字

把告警和当时的现场绑在一起,它才指得出下一步。

屏幕上一个实时功率数字只说明此刻。把一周的曲线拉出来,设备从高功率掉进温控、再慢慢恢复的全过程才看得见——哪台总在某个阶段降功率,哪个口长期扛主负载,哪根线在高功率下不稳,都得有时间维度才判得出。

告警也一样,孤零零跳一个出来没用。Mirror 的 Telemetry 把它和现场捆在一起:温度报警的那一刻,哪些口在工作、功率怎么分、有没有刚插进来一台新设备,一并记成结构化事件,能进历史、进看板、进自由流的解释、进自动化规则。

有了上下文,告警变成动作:等降温、换模式、查线材、看端口占用,或回放刚执行的那条任务。

体验官报名

留言